

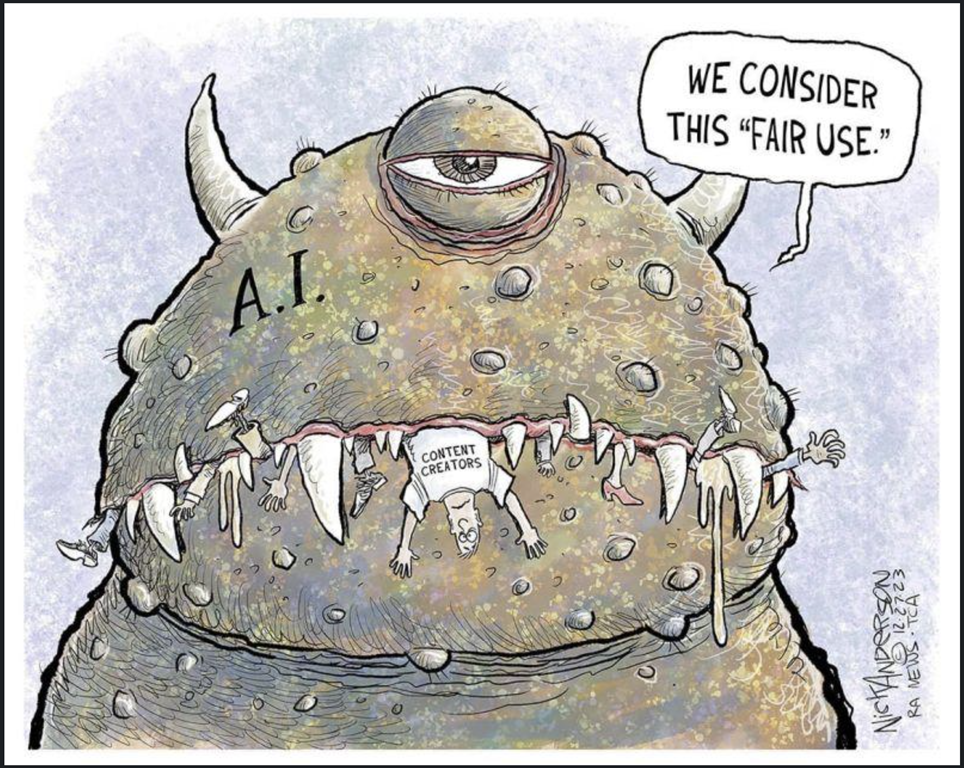
 Er is in Amerika een grote rechtszaak aan de gang die ten onrechte onder de radar vliegt. Het gaat om de New York Times vs OpenAI (en Microsoft) copyright rechtszaak (gestart op 27 december 2023); vrij vertaald: de grootschalige roof van New York Times content door Open AI. Voor de volledigheid, vóór de start van deze rechtszaak hebben (NYT) en OpenAI geprobeerd er onderling uit te komen. Dat is dus niet gelukt…
Het standpunt van OpenAI is dat het gebruiken van openbaar toegankelijke teksten om een AI-model te trainen valt onder de Amerikaanse fair use-doctrine. Zij vergelijken het trainen van AI met een mens die boeken leest om er iets nieuws van te leren en te creëren (transformative use).
Het standpunt van de NYT is dat OpenAI op industriële schaal Inbreuk maakt op het auteursrecht: OpenAI en Microsoft hebben miljoenen artikelen van de NYT zonder toestemming of vergoeding gebruikt (gescraped) om hun Large Language Modellen (LLM’s) zoals GPT-3 en GPT-4 te trainen.
En natuurlijk was er ook nog deze bijdrage (1 september 2026) van de Amerikaanse regering: For all these reasons, the United States has a strong interest in this Court rejecting any argument that training LLMs on copyrighted texts violates copyright law.
Je denkt wellicht: boring, en in principe is een rechtszaak niet het meest spannende schouwspel wat je kan verwachten. Maar dat is in deze zaak anders omdat enkele dagen geleden er een ‘explosief’ document is vrijgegeven door de rechtbank. En de informatie uit dit document is verwoestend voor de positie van OpenAI/Microsoft:
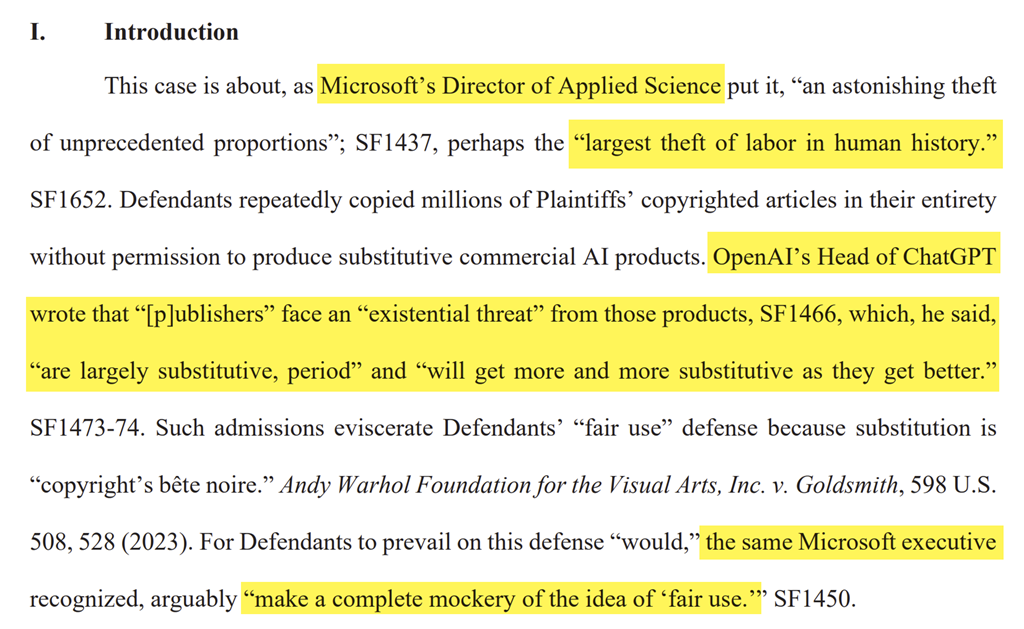
The filing was written by lawyers for the New York Times but is largely comprised of statements and interviews with big tech executives that admit both that LLMs are largely trained on stolen content, that they represent an existential risk for the human writers, artists, and media companies that they stole from, and that their products have started a “doom loop” that is eating the web and destroying the businesses that these companies stole from.
Dat is nogal wat, toch? Om deze, nogal pittige claim wat vlees om de botten te geven, hierbij wat snippets uit het document:
En wat dacht je van dit ‘verweer’ Microsoft’s CEO Nadella?:
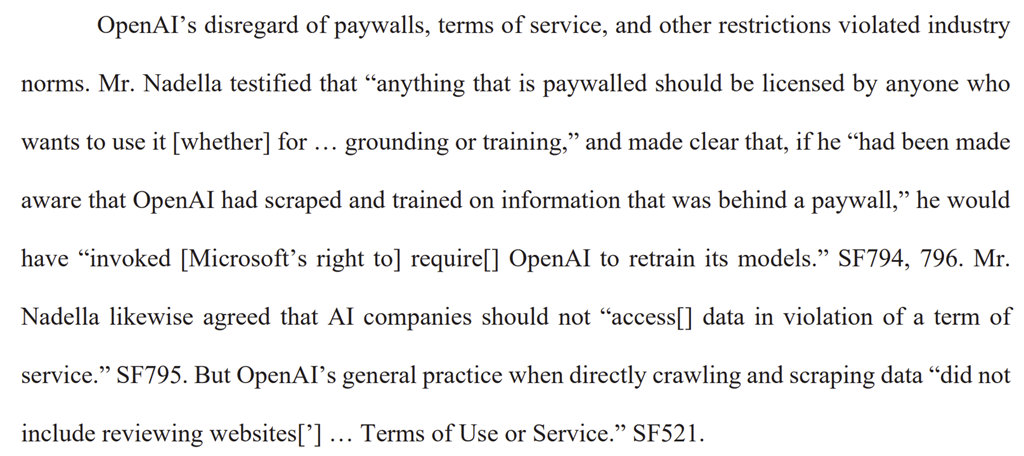
Onthutsend, zou ik zeggen. Zou de goede man nooit hebben gehoord van the buck stops here? Hij probeert in ieder geval OpenAI als de kwade genius af te schilderen om zichzelf lelieblank te portretteren.
En dan is er nog deze uitspraak vanuit Microsoft:
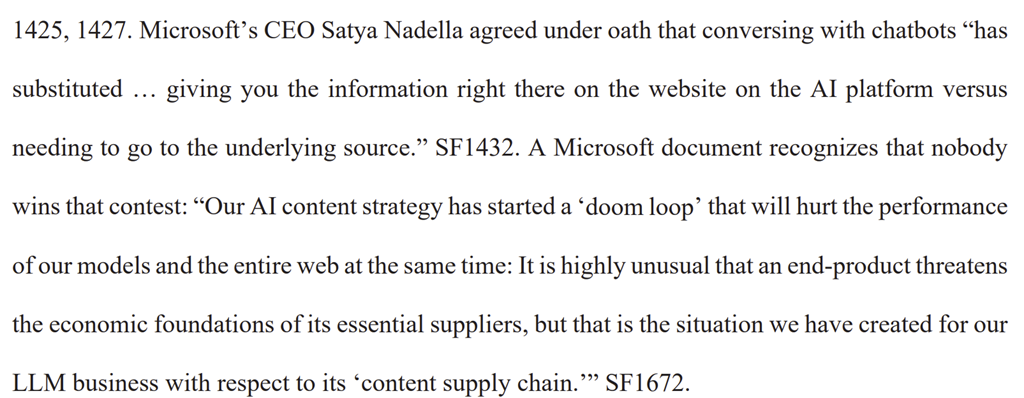
De doom loop is de parasitaire cyclus, gestart door LLM-bedrijven met het roven van alle online content zonder enige tegenprestatie waardoor content providers inkomsten mislopen die leiden tot de krimp en/of ondergang van content providers waardoor parasitaire LLM-bedrijven minder/niets kunnen roven.
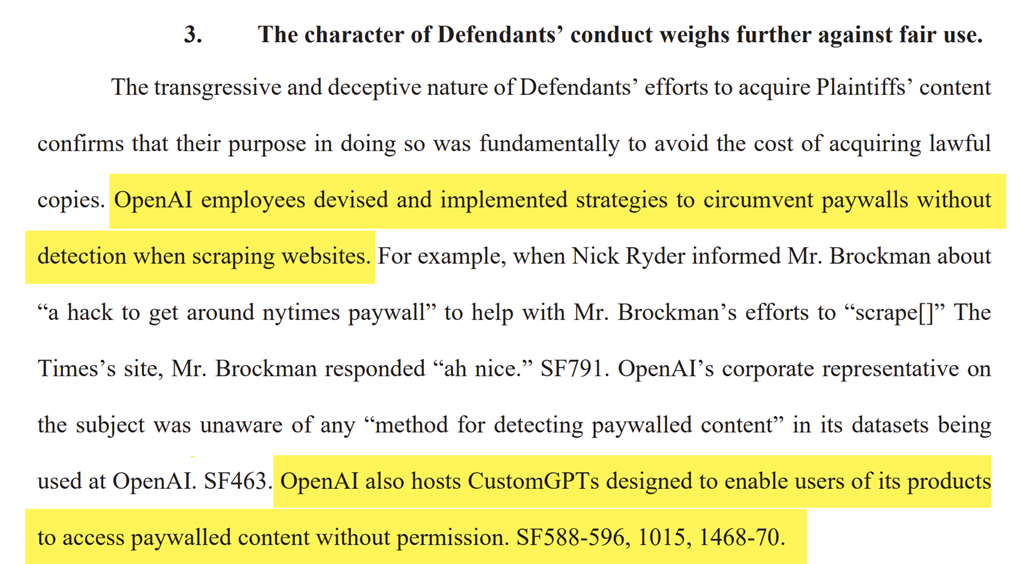
En als toetje nog even dit, om ondubbelzinnig aan te geven dat OpenAI geen innocent bystander is:
Misselijkmakend. Dit is C-level…