In mijn (ongetwijfeld) prijswinnende blog over moderne AI
maakte ik de eerste wet van moderne AI (don’t harm the humans) wereldkundig. Vandaag maak ik de wereld kundiger met een Monopoly voorbeeld van de wet K-k<K. Jawel.
(meer…) Dirk Goossens
In mijn (ongetwijfeld) prijswinnende blog over moderne AI
maakte ik de eerste wet van moderne AI (don’t harm the humans) wereldkundig. Vandaag maak ik de wereld kundiger met een Monopoly voorbeeld van de wet K-k<K. Jawel.
(meer…) Marc Drees
 Enkele dagen geleden struikelde ik weer eens over een posting over (AI) skills op LinkedIn. En niet voor de eerste keer werd daar de skills taxonomie van het World Economic Forum (WEF) aangehaald. Nee, nu niet meteen in slaap vallen. Taxonomie mag dan een moeilijk woord (>3 lettergrepen) zijn, de inhoud van een taxonomie is dat zeker niet. En in het geval van het WEF is het zelfs lachwekkend simpel. Maar ik loop op de zaak vooruit.
Eerst is het goed om stil te staan bij de voormalige bubble die skill matching heet. Hopelijk is het leeuwendeel (of is het leeuwedeel?) van het recruitment domein bekomen van de niet-nagekomen beloftes van de slangenolieverkopers van skills-matching engines. Maar er zijn nog wat hardnekkige skill-fanboys/girls die elk redelijk en praktisch argument negeren en trots rondparaderen als ze een cv van een chirurg op de vacature van een schilder hebben gematched. Anyway, skills-matching heeft natuurlijk een taxonomie nodig, omdat je appels (skills in cv) wilt vergelijken met appels (skills in vacature). En bam! hier is het onoplosbare probleem van skills matching schrijnend duidelijk: cv’s en vacatures moeten langs dezelfde meetlat worden gelegd. Maar welk werkzoeker is zo gek om zijn/haar/x cv aan te passen aan de (niet zelden ondoordringbare) taxonomie van match-engine X (en Y, en Z, en… want niet elke vacaturesite gebruikt dezelfde match-engine). En dat is nog even los van het feit dat een werkzoeker geen taxonomie expert is, en dat ook zeker niet wil worden (uitzonderingen daargelaten). Laat nou ook nog eens de gemiddelde recruiter dezelfde karakteristiek hebben als de gemiddelde werkzoeker en je hebt meteen duidelijk wat voor Babylonische spraakverwarring een match-engine introduceert. En alsof allemaal niet genoeg is, met de taxonomie voldoende granulair zijn en onderhouden worden…. Met andere woorden, een taxonomie is een beerput. En nee, de match-engine het cv en de vacature automatisch laten verrijken is zeker geen oplossing. Tenzij je liever lui dan moe bent.
Marc Drees In een artikel met de titel The ‘dead internet theory’ is real. And it’s killing the web as we know it geeft auteur Rita McGrath een verontrustend beeld van de toestand van het Internet:
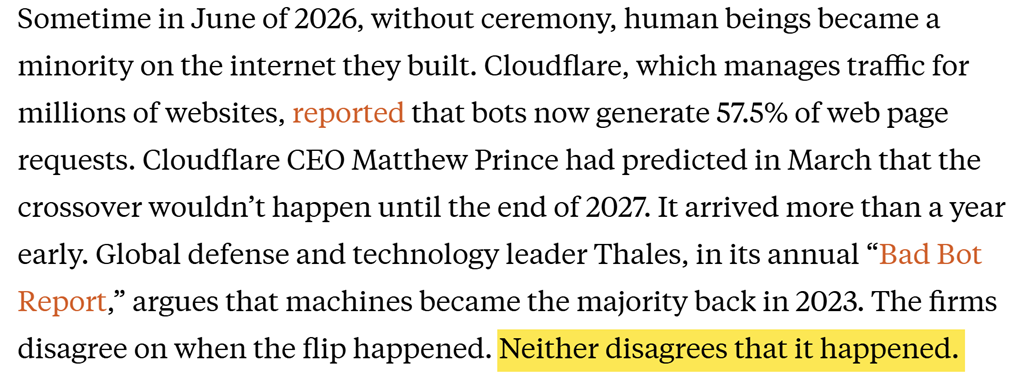
Fragment uit The ‘dead internet theory’ is real. And it’s killing the web as we know it, 28 juli 2026
Dirk Goossens 
Klassieke AI is compressie.
Daar kun je handige dingen mee doen.
Moderne AI, LLM’s, is compressie met een verstopte dobbelsteen.
Daar kun je geen handige dingen mee doen, in ieder geval minder handige dingen dan wanneer je de dobbelsteen niet verstopt.
In formulevorm:
K = alle kennis
k = kennis van de verstopte dobbelsteen
K – k < K
Verbaasd zijn dat jouw AI oplossing niet werkt is de eerste wet van moderne AI negeren.
Werken met moderne AI is als je geld naar het casino brengen.
Als je anderen verplicht in aanraking brengt met AI, als medewerker, klant of burger, zeg dan sorry en ga iets anders doen.
Ben ik de enige die het ziet?
Marc Drees  Gisteren verscheen de vierde aflevering van het veelluik dat René Veldwijk schrijft over 8vance (en UWV), naar aanleiding van de sommatiebrief die hij van de advocaat van 8vance heeft ontvangen. En dit keer gaat het over een zeer vertrouwd onderwerp (voor oplettende lezertjes van RecruitmentMatters) wat Veldwijk als volgt omschrijft:
Maar moderne AI (dus niet de regeltjes-AI uit de vorige eeuw) vereist data, heel veel data, om een AI-algoritme (dat feitelijk geen algoritme is) te trainen. Een kleine, straatarme startup uit Limburg heeft die persoonsdata niet en kan ze ook niet kopen. Maar de deur bij LinkedIn staat wagenwijd open, waarna webscrapingspecialist 8vance meer dan 85 miljoen LinkedIn-profielen van het internet schraapt.
Marc Drees  Er zijn tot een half miljoen taxichauffeurs in Europa. Hoeveel hiervan voor Uber werken is onduidelijk. En hoeveel hiervan door Uber (al dan niet tijdelijk) zijn gedeactiveerd is evenmin duidelijk. Maar de hoogte van de boete (EUR 824.990.000) die de Autoriteit Persoonsgegevens (AP) aan Uber heeft opgelegd, is zeer duidelijk en zeer precies; 4% van Uber’s wereldwijde omzet. Natuurlijk gaat Uber in beroep, en het is bepaald niet haar eerste beroepszaak tegen de AP. De door AP geconstateerde overtreding van Uber is het via een algoritme (dus zonder betekenisvolle mensenlijke tussenkomst) tijdelijk danwel permanent deactiveren van chauffeurs. Management by algoritm mag niet. Volgens de AP, en de EU. Maar tot wanneer?
Marc Drees 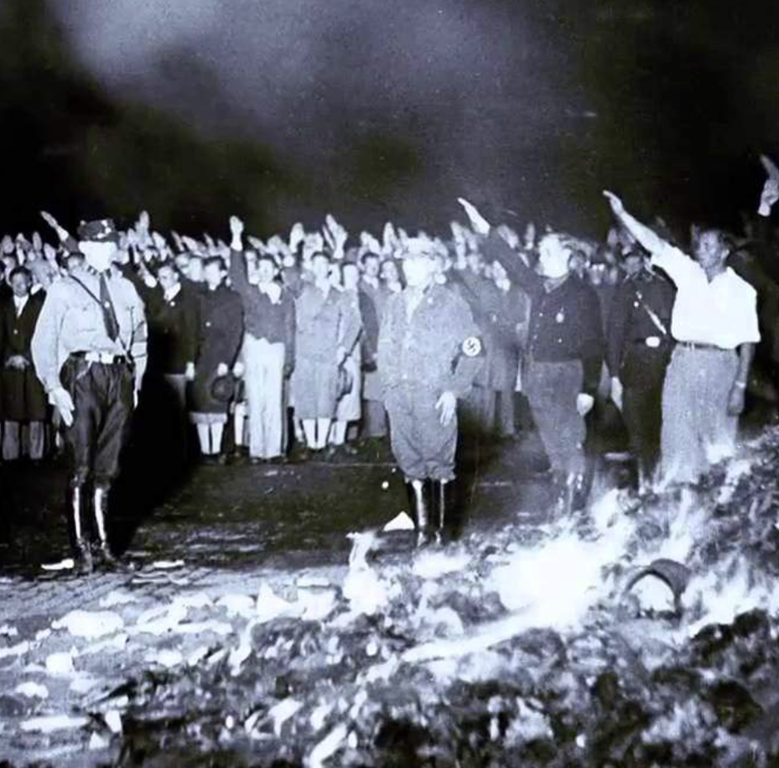 Het lijkt paradoxaal, LLM-aanbieders (OpenAI, Anthropic, Meta, Google) die massaal fysieke boeken van vóór 2022 opkopen, maar het is volstrekt logisch. De drijvende kracht achter het opkopen van fysieke boeken door AI-bedrijven is de urgente behoefte aan hoogwaardige, door mensen geschreven teksten van vóór de grootschalige beschikbaarheid van LLM’s (eind 2022). Het Internet vult zich sindsdien in toenemende mate met door AI geïnfecteerde inhoud (AI-slop). Wanneer een LLM wordt getraind op deze content dan treedt er kwaliteitsverlies op in de output van LLM’s (model collapse). Fysieke boeken van vóór 2022 bieden content voor trainingsdoeleinden zonder dit risico. Bovendien proberen LLM-aanbieders hiermee ook juridische risico’s rondom digitale piraterij te omzeilen door boeken legaal in bulk aan te schaffen, maar laat ik me eerst richten op de opkooppraktijk.
Marc Drees  Met pathalogisch leugenaar bedoel ik natuurlijk Sam Altman, de CEO van OpenAI, die recent een paar krankzinnige uitspraken deed:
“I thought when we got to GPT-4, which was back in 2023, that very quickly after that there was going to be much more disruption, software businesses up for grabs right away, than it turned out to be.”
Dit is niet direct krankzinnig, maar een sterk misplaatste overtuiging van de impact van LLM’s. Maar met onderstaande ontboezeming wordt het al wat erger:
“I think I was wrong about a few things, but one in terms of the speed: the economy just has so much inertia.”
Marc Drees  Ik wil toch even stilstaan bij een uniek moment in het bestaan van onze planeet want volgens de CEO van OpenAI, Sam Altman, leven we op dit moment in de singularity. Mooi toch? En de goede man is natuurlijk een altruïst die geen enkel belang heeft bij het oppompen van het LLM imago… IPO, anyone?
De vraag is alleen op welke manier deze singularity wordt bereikt; en er zijn feitelijk twee* primaire paden: