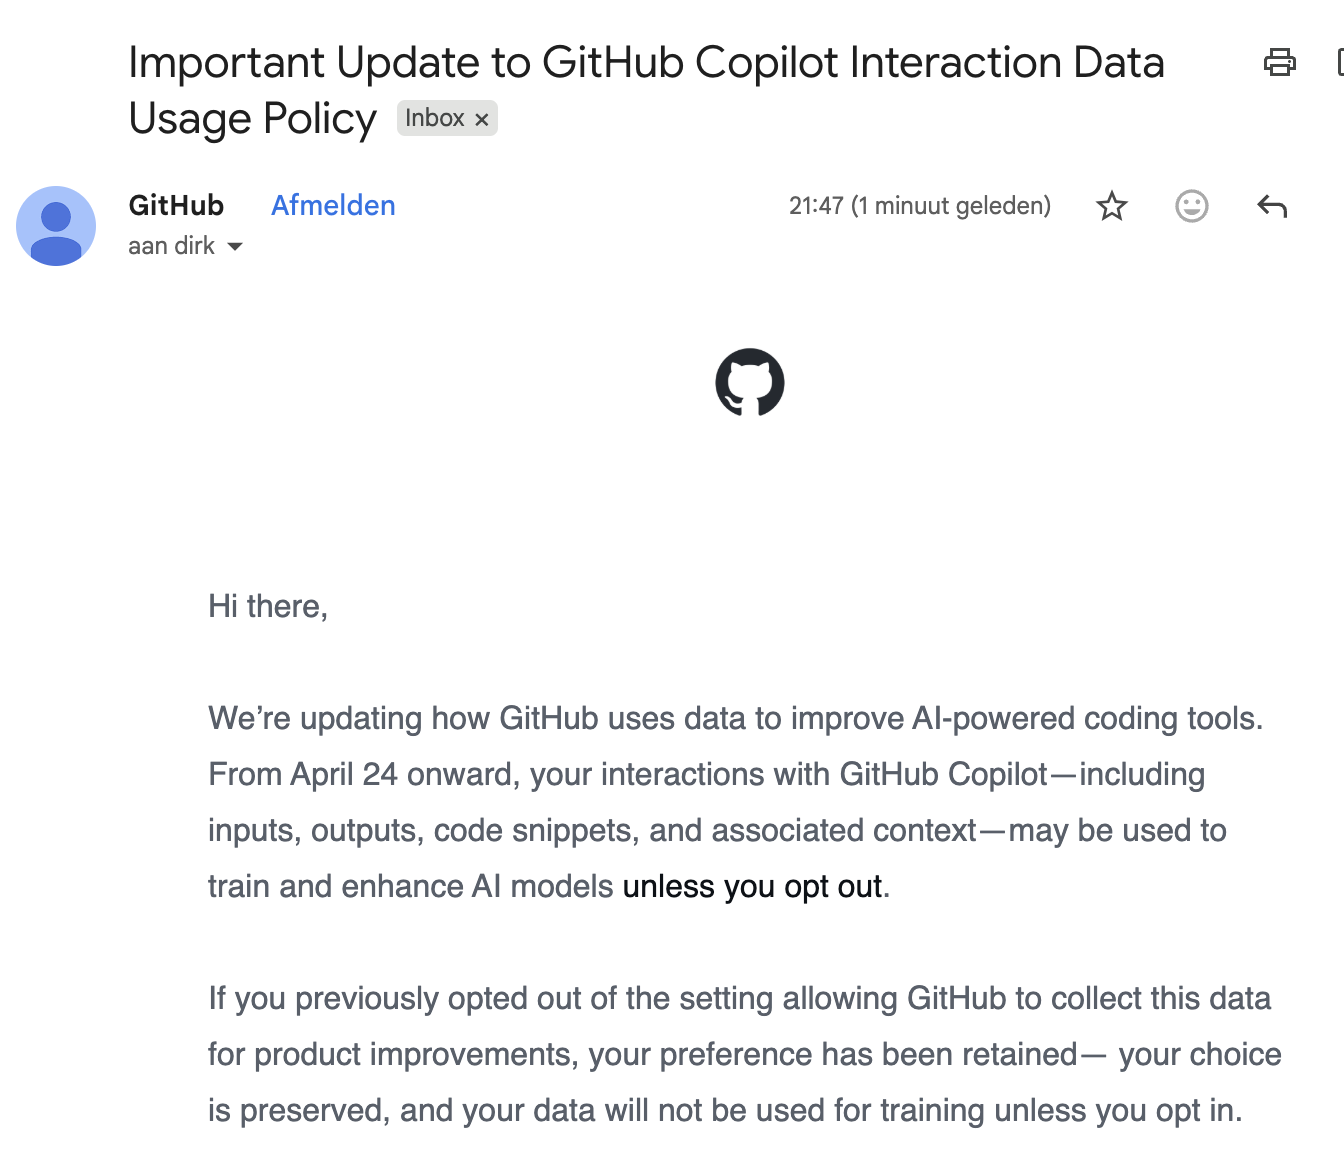
GitHub gaat je code voeren aan OpenAI, tenzij je weet uit te vogelen waar de opt-out knop zit.
(meer…) Dirk Goossens
GitHub gaat je code voeren aan OpenAI, tenzij je weet uit te vogelen waar de opt-out knop zit.
(meer…)
Dirk Goossens 
Sora is de videogenerator van OpenAI. Nos.nl meldt dat Sora stopt.
Er zijn genoeg redenen te verzinnen waarom ze de stekker eruit trekken. Het is een verrassend impopulaire plagiaat generator die miljarden kost en miljoenen oplevert.
https://www.forbes.com/sites/phoebeliu/2025/11/10/openai-spending-ai-generated-sora-videos
Het wordt vooral gebruikt door artiesten die materiaal maken om OpenAI mee aan te klagen. Dat is dus geen recept voor succes. Totdat je het bekijkt vanuit het perspectief van Sam Altman.
(meer…) Laurens Tienkamp
“Een maand geleden kon ik geen regel code schrijven, maar nu maak ik productie-ready recruitment software.”. Workflows die profielen scrapen (AVG anyone?), geautomatiseerd connectieverzoeken sturen en daabij indrukwekkende Excel-sheet produceren. Nee.
Ik word er niet eens meer boos van, ik word er moe van. Want het is een epidemie. Je hoeft tegenwoordig maar één workflow aan elkaar te klikken, een project te openen en drie keer het woord “agent” te laten vallen, en daar is weer een nieuwe AI-expert. Niet iedereen natuurlijk. Maar wel genoeg om het hele ecosysteem vakkundig te vervuilen. En ik weiger m’n mond hierover te houden, ook al levert me het een block op LinkedIn op.
(meer…) Marc Drees
 Enkele weken geleden struikelde ik over Talvy, een early-stage start-up die maar liefst $2 miljoen aan seed funding wist op te halen met de belofte om het ‘traditionele’ cv te elimineren. Maar wat komt daarvoor dan in de plaats?: short-form video profiles! I kid you not:
Talvy is a video-first profile that replaces the traditional resume. Share your career story through short-form videos and let employers see the real you, not just a PDF.
Marc Drees Er wordt zo makkelijk aan voorbijgegaan, data is een gegeven. In overvloed aanwezig en niets om je zorgen over te maken. Maar dat is toch iets kort door de bocht. En om dat nog eens heel erg duidelijk te maken; in onderstaand schema staan maar liefst 15 dimensies van data. En dat terwijl er in mijn optiek ook nog eentje ontbreekt: Data quality. Want waar ben je als je geen actuele en correcte data hebt? Inderdaag, in de aap gelogeerd:
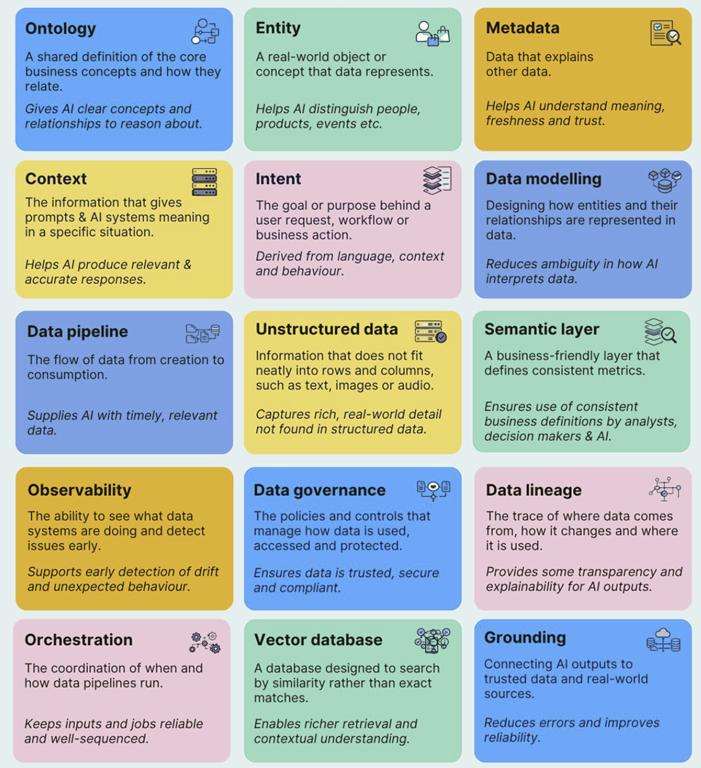
15 data concepts for the age of AI – Clare Kitching
Marc Drees  Het ATS Workable heeft binnen haar Help omgeving een hele pagina besteed aan de Disposition Sync API van Indeed. En hierin geeft het ATS meer informatie over de Indeed data grab dan ik bij veel andere ATS’en heb gezien. En dat is mooi. Minder mooi is dat Workable onder haar motto “We value data protection and Privacy” juist op dat gebied haar gebruikers een gigantisch oor aannaait. Waarmee haar gebruikers bij een rechtszaak van een boze werkzoekende weleens aan het korte eind zou kunnen trekken.
Workable begint met een stroomschema dat er zeer onschuldig uitziet:
Marc Drees  Voor niet-ingewijden is de titel van deze blog posting mogelijk nogal cryptisch, dus laat ik eerst even uitleggen wat daar staat. Op 2 februari heeft het Adviescollege ICT-toetsing haar evaluatie gepubliceerd van het UWV project Bemiddelingsservice (BMS) fase 1. Hier is op 12 maart door de minister van SZW een reactie gegeven (Aanbiedingsbrief TK AcICT advies project BMS). Voor de geïnteresseerde lezer; op 3 maart is binnen het ministerie van SZW een ambtelijke notitie (beslisnota) gepubliceerd (Kamerbrief over advies van Adviescollege ICT-toetsing op project BMS), dit is een intern advies aan de Minister. Dat heeft geleid tot de Aanbiedingsbrief, en om dit laatste document gaat het in deze blog posting.
De Aanbiedingsbrief begint met het schetsen van het podium:
 Michel Rijnders
In recruitment vindt een technologische wapenwedloop plaats, een ‘rat race’ met de inzet van AI. Kandidaten zetten AI in om op grote(re) schaal te solliciteren en werkgevers zetten vervolgens AI in om de hieruit volgende vloedgolf aan sollicitaties te beheersen.
In het slagveld van deze ontwikkelingen ontstaat er meer en meer een systeem waarin kwantiteit de kwaliteit verdringt en de werkelijke match tussen mens en organisatie onder druk staat. Wanneer we op deze weg doorgaan verwerken we steeds meer data voor steeds hogere kosten om tot slechtere resultaten te komen.
(meer…)
Marc Drees  Findem is een people aggregator. En dat betekent dat Findem persoonsgegevens stofzuigert van het Internet, zonder toestemming van de personen wiens gegevens worden opgezogen. En vervolgens biedt Findem deze persoonsgegevens te koop aan. Maar wat zegt Findem over zichzelf?:
Findem is the AI platform built for talent outcomes. Its Labeling Engine transforms billions of unstructured people data points into verified Success Signals — context about what drives success — and Relationship Signals — insight into how people are connected and where influence flows. Together, these insights give organizations a competitive edge in hiring, executive search, internal mobility, learning and development, and workforce planning.
Godskolere, dat is een dikke duim geweest waar bovenstaande bagger uit is gezogen. Findem is een elitair klinkend duizend-dingen-doekje, zoveel is duidelijk. En natuurlijk ook volstrekt onrechtmatig in Europa, maar dat is een detail…