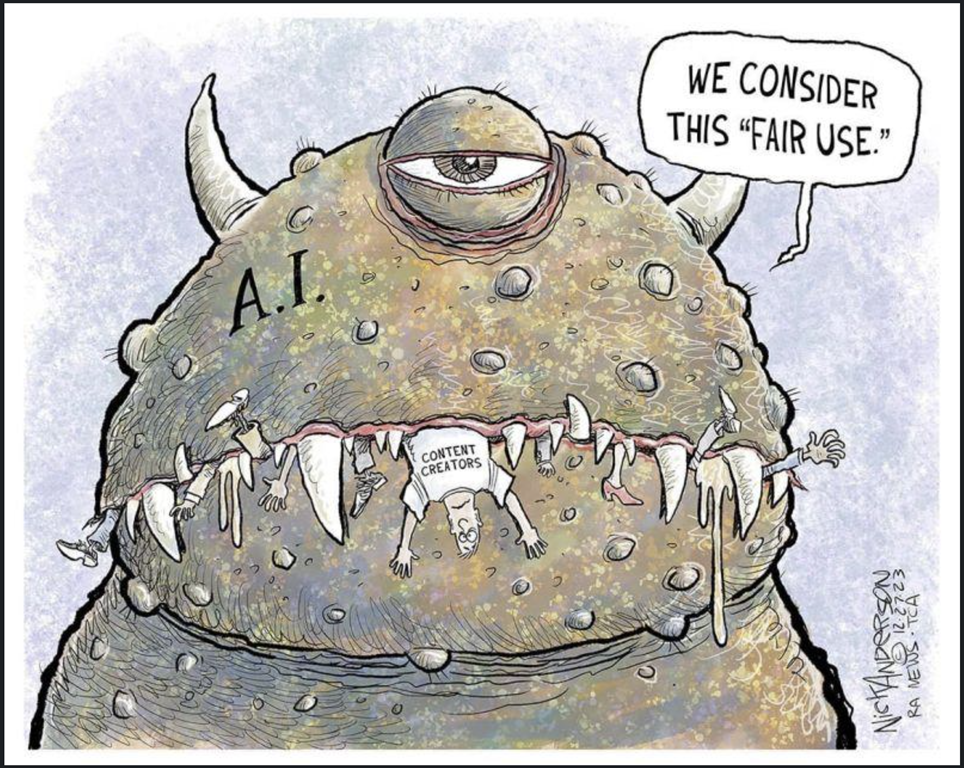
 Er is in Amerika een grote rechtszaak aan de gang die ten onrechte onder de radar vliegt. Het gaat om de New York Times vs OpenAI (en Microsoft) copyright rechtszaak (gestart op 27 december 2023); vrij vertaald: de grootschalige roof van New York Times content door Open AI. Voor de volledigheid, vóór de start van deze rechtszaak hebben (NYT) en OpenAI geprobeerd er onderling uit te komen. Dat is dus niet gelukt…
Het standpunt van OpenAI is dat het gebruiken van openbaar toegankelijke teksten om een AI-model te trainen valt onder de Amerikaanse fair use-doctrine. Zij vergelijken het trainen van AI met een mens die boeken leest om er iets nieuws van te leren en te creëren (transformative use).

 We mogen aannemen dat we op de piek van de hype cycle zitten met large language model AI, met de komst van ChatGPT, Bing + GPT (Microsoft) en Bard (Google). En dan is het goed om even afstand te nemen en te zien of er enig tegengeluid binnen het getoeter is te horen. En dat is er natuurlijk. Het leek me goed om dat te delen.